OCR-Texterkennung aus Bildern und PDFs

Online-Werkzeug zur Texterkennung in Fotos, Scans und PDFs. Eine Engine auf Basis neuronaler Netze liest das Dokument direkt im Browser auf Deutsch, Englisch und in über 100 weiteren Sprachen, richtet gedrehte Aufnahmen auf und begradigt die Zeilen von Handyfotos; Ergebnis ist bearbeitbarer Text, Word, Excel oder ein durchsuchbares PDF mit unsichtbarer Textebene.

So extrahieren Sie Text aus Bild oder PDF

1
Dateien hinzufügen

Bilder oder PDFs ablegen, das Dokument mit der Handykamera fotografieren oder einen Screenshot mit Strg+V einfügen.

2
Sprache wählen

Die Standardeinstellung deckt die Website-Sprache plus Englisch ab; für andere Dokumente bis zu drei Sprachen aus der gruppierten Liste wählen.

3
Ausgabe-Stil wählen

Fließtext zum Kopieren, „Layout erhalten“ für Dokumente, „Tabellen extrahieren“ für Excel oder „Beleg“ für Gesamtbetrag, Datum und Händler.

4
Prüfen und bearbeiten

Bounding-Boxen prüfen, Wörter mit niedriger Zuverlässigkeit korrigieren, bestimmte Begriffe suchen.

5
TXT, DOCX, XLSX oder durchsuchbares PDF

Als TXT, DOCX, XLSX oder durchsuchbares PDF laden — oder ganzen Stapel als ZIP.

Scans, Fotos und PDFs in bearbeitbaren Text, Word, Excel oder durchsuchbares PDF verwandeln

Bilder oder PDFs hier ablegen

Oder Strg+V, um einen Screenshot einzufügen

Wird bearbeitet …

Hohe Zuverlässigkeit Mittel Niedrig — prüfen

Box anklicken, um zum Wort zu springen · Wort anklicken, um die Box hervorzuheben · Jedes Wort direkt bearbeiten — Korrekturen werden in den Export übernommen.

QR-Code erkannt:

Export

Weitere Formate und Aktionen
Läuft im Browser über WebAssembly. Funktioniert nach dem ersten Einsatz offline.

Tastaturkürzel

Ctrl+VBild aus Zwischenablage einfügen Ctrl+FIm extrahierten Text suchen Ctrl+EnterExtraktion starten EscAktuelle Aktion abbrechen [ / ]Zum nächsten Wort mit niedriger Zuverlässigkeit Ctrl+scrollBildvorschau zoomen
Dokument in den Rahmen legen · ruhig halten · zum Auslösen tippen

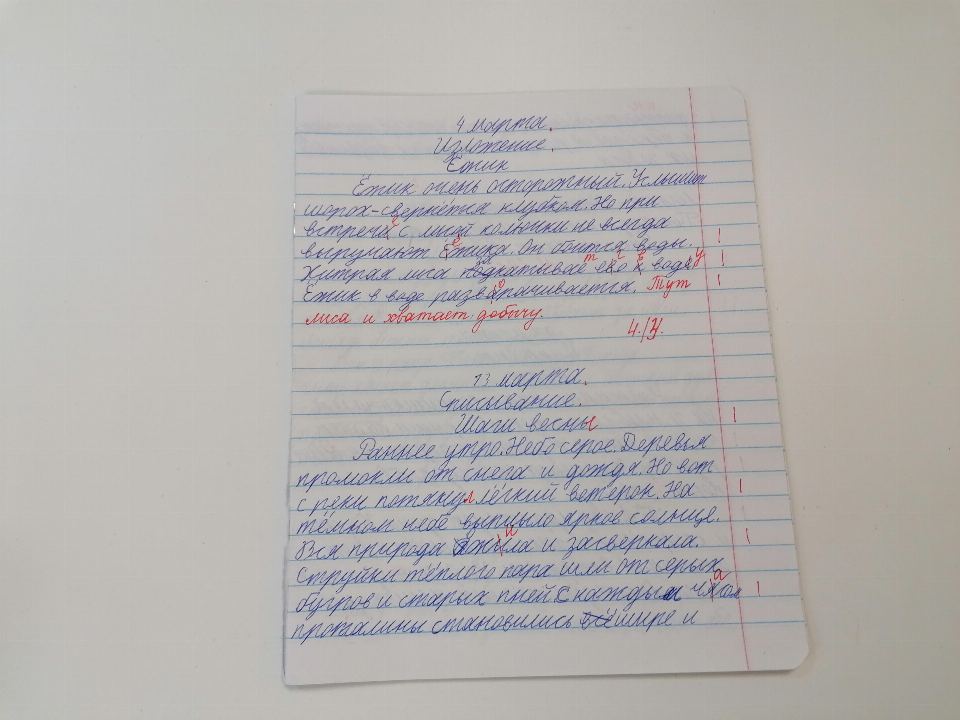
Der genaue Modus auf echten handschriftlichen Seiten

Das Foto einer Seite und der Text, den der genaue Modus dafür geliefert hat — wörtlich und unbearbeitet, mit seinen Fehlern.

Foto einer handschriftlichen Seite
Quelle: School Notebooks RU — ai-forever, MIT · Lizenz
Erkannt
4 марта.
Изложение.
Ёжик
Ёжик очень осторожный. Услышит
шорох - свернётся клубком. Но при
встрече с лисой колючки не всегда
выручают ёжика. Он боится воды.
Хитрая лиса подкатывае его к воде. У
Ёжик в воде разворачивается. Тут
лиса и хватает добычу.
4/3.
13 марта.
Списывание.
Шаги весны
Раннее утро. Небо серое. Деревья
промокли от снега и дождя. Но вот
с реки потянул лёгкий ветерок. На
тёмном небе выплыло яркое солнце.
Вся природа ожила и засверкала.
Струйки тёплого пара шли от серых а
бугров и старых пней с каждым часом
проталины становились всё шире и
Veröffentlicht Aktualisiert Autor: