KI-Kurs für Einsteiger
Lernen Sie, der künstlichen Intelligenz klare Aufgaben zu stellen und ihre Antworten zu prüfen
- Wie KI funktioniert – ohne Zauberei
- Wie man um Texte bittet
- Faktencheck und „Halluzinationen“
- Bilder
- Weitere Etappen: 4
Online-Werkzeug zur Texterkennung in Fotos, Scans und PDFs. Eine Engine auf Basis neuronaler Netze liest das Dokument direkt im Browser auf Deutsch, Englisch und in über 100 weiteren Sprachen, richtet gedrehte Aufnahmen auf und begradigt die Zeilen von Handyfotos; Ergebnis ist bearbeitbarer Text, Word, Excel oder ein durchsuchbares PDF mit unsichtbarer Textebene.
Bilder oder PDFs ablegen, das Dokument mit der Handykamera fotografieren oder einen Screenshot mit Strg+V einfügen.
Die Standardeinstellung deckt die Website-Sprache plus Englisch ab; für andere Dokumente bis zu drei Sprachen aus der gruppierten Liste wählen.
Fließtext zum Kopieren, „Layout erhalten“ für Dokumente, „Tabellen extrahieren“ für Excel oder „Beleg“ für Gesamtbetrag, Datum und Händler.
Bounding-Boxen prüfen, Wörter mit niedriger Zuverlässigkeit korrigieren, bestimmte Begriffe suchen.
Als TXT, DOCX, XLSX oder durchsuchbares PDF laden — oder ganzen Stapel als ZIP.
KI-Kurs für Einsteiger
Lernen Sie, der künstlichen Intelligenz klare Aufgaben zu stellen und ihre Antworten zu prüfen
Audio in Text
Machen Sie aus einer aufgezeichneten Unterhaltung ein lesbares Dokument: wer hat wann was gesagt
Gerade beliebt
Bilder oder PDFs hier ablegen
Oder Strg+V, um einen Screenshot einzufügen
Für schlechte Scans, Handy-Fotos oder verrauschte Quittungen aktivieren.
Alle Dateien sind mit diesen Einstellungen bereits erkannt. Ändern Sie Sprache oder Ausgabestil, dann liest die Schaltfläche sie neu.
Box anklicken, um zum Wort zu springen · Wort anklicken, um die Box hervorzuheben · Jedes Wort direkt bearbeiten — Korrekturen werden in den Export übernommen.
Das Foto einer Seite und der Text, den der genaue Modus dafür geliefert hat — wörtlich und unbearbeitet, mit seinen Fehlern.
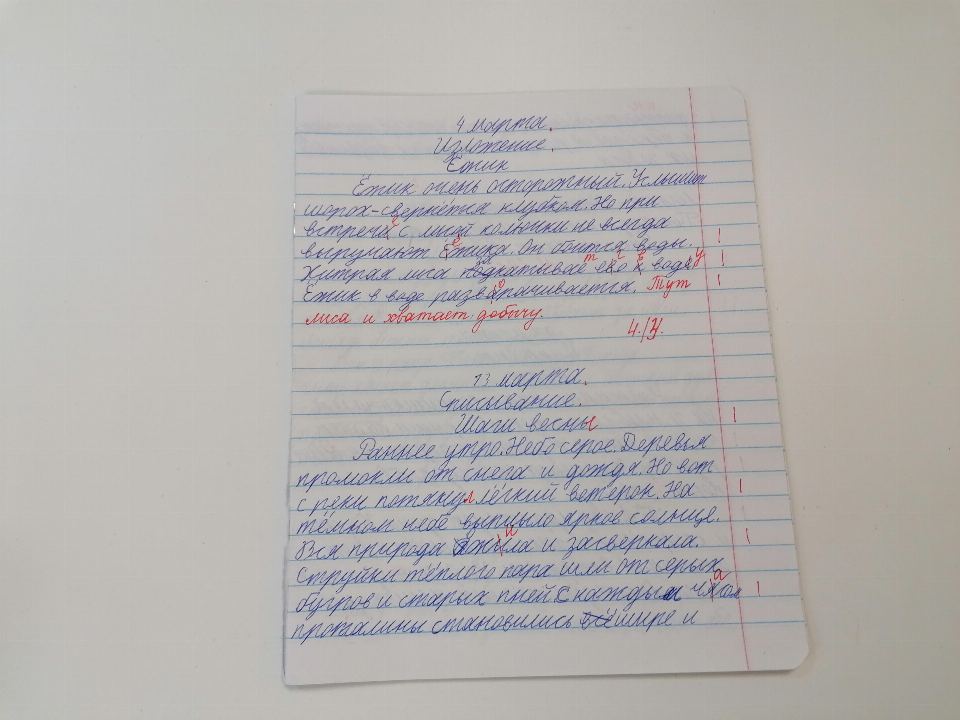
4 марта.
Изложение.
Ёжик
Ёжик очень осторожный. Услышит
шорох - свернётся клубком. Но при
встрече с лисой колючки не всегда
выручают ёжика. Он боится воды.
Хитрая лиса подкатывае его к воде. У
Ёжик в воде разворачивается. Тут
лиса и хватает добычу.
4/3.
13 марта.
Списывание.
Шаги весны
Раннее утро. Небо серое. Деревья
промокли от снега и дождя. Но вот
с реки потянул лёгкий ветерок. На
тёмном небе выплыло яркое солнце.
Вся природа ожила и засверкала.
Струйки тёплого пара шли от серых а
бугров и старых пней с каждым часом
проталины становились всё шире и
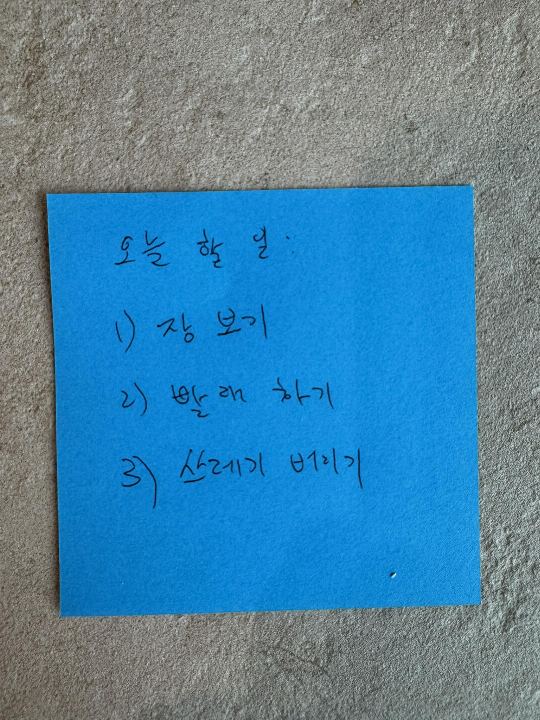
오늘 할 일 :
1) 장 보기
2) 빨래 하기
3) 쓰레기 버리기
KI-Kurs für Einsteiger
Lernen Sie, der künstlichen Intelligenz klare Aufgaben zu stellen und ihre Antworten zu prüfen
Audio in Text
Machen Sie aus einer aufgezeichneten Unterhaltung ein lesbares Dokument: wer hat wann was gesagt
Eingabe: JPG, PNG, WebP, TIFF, BMP, HEIC, PDF (mehrseitig). Ausgabe: TXT, DOCX, XLSX, durchsuchbares PDF, Markdown, JSON mit Bounding-Boxen.
Sauber gedruckter Text wird nahezu fehlerfrei erkannt; Handyfotos und verblasste Scans sind schwieriger. Die Engine richtet gedrehte Aufnahmen auf und liest jede Zeile in ihrem eigenen schrägen Rahmen; Wörter mit niedriger Zuverlässigkeit werden hervorgehoben, damit sie sich vor dem Export korrigieren lassen.
Deutsch, Englisch und die übrigen Sprachen in lateinischer und kyrillischer Schrift, Chinesisch, Japanisch, Koreanisch, Arabisch, Griechisch, Hindi und Thai liest die neuronale Engine; rund hundert weitere – Hebräisch, Georgisch, Vietnamesisch, Bengalisch und andere – erkennt Tesseract. Die Sprachen sind in der Liste nach Schrift gruppiert; Modelle laden beim ersten Einsatz und bleiben im Browser-Cache.
Ja. Mehrseitige PDFs werden seitenweise per pdf.js gerendert und dann durch OCR geschickt. Das Ergebnis lässt sich als durchsuchbares PDF mit unsichtbarer Text-Schicht exportieren — Strg+F funktioniert, Screenreader können es lesen.
Der normale Modus ist auf Druckschrift abgestimmt: saubere Handschrift mit getrennten Buchstaben ist oft lesbar, Schreibschrift nicht. Für Handschrift gibt es „Genauer erkennen“: Die Seite wird an einen Erkennungsserver gesendet und von einem Modell für Handschrift gelesen. Auf Seiten aus Schulheften las er fast 9 von 10 Wörtern richtig, der normale Modus weniger als 1 von 10.
Nach dem OCR werden erkannte Wörter nach ihrer vertikalen Position in Zeilen gruppiert und per horizontale Lücken in Spalten geteilt. Sobald mindestens drei Zeilen dieselbe Spaltenzahl haben, behandeln wir das als Tabelle und exportieren sie nach Excel; sonst enthält die Excel-Datei eine einzelne Textspalte.
Die Warteschlange nimmt bis zu 50 Dateien auf. Wie viele Dateien pro Tag erkannt werden und wie viele PDF-Seiten ein Durchlauf liest, steht im Kasten über der Schaltfläche „Text extrahieren“. Die maximale Dateigröße richtet sich nach dem Gerät (etwa 80 MB auf Handys, bis zu 1 GB auf Desktops); PDFs werden Seite für Seite verarbeitet, und bei einem großen Dokument wählen Sie den Seitenbereich.
Machen wir! Schreiben Sie uns kurz Ihre Idee. Wenn Sie sie im Detail besprechen möchten, hinterlassen Sie eine E-Mail-Adresse, wir melden uns. Anonym geht auch.
Mit dem Hochladen bestätigen Sie, dass Sie zur Weitergabe des Inhalts an Dritte berechtigt sind, und verpflichten sich, keine personenbezogenen Daten Dritter aufzunehmen. Einzelheiten in den Nutzungsbedingungen. KI-Anbieter Tembrica ist ein unabhängiges Produkt. Wir stehen in keiner Verbindung zu den Herstellern der hier genannten Modelle und Dienste und werden von ihnen weder unterstützt noch gesponsert; ihre Namen dienen allein der sachlichen Angabe, welche Engine ein Werkzeug antreibt.
Melden Sie ein Problem oder schlagen Sie eine Verbesserung vor. Wir lesen jede Nachricht!
Ihre Nachricht wurde gesendet. Wir schauen sie uns zeitnah an.
Оплата через СБП · ₽
Откройте приложение банка, выберите «Оплатить по QR» и наведите камеру на код.
Открыть приложение банкаЖдём подтверждения от банка…
Открыть ссылку на оплату