Curso de inteligencia artificial para principiantes
Aprende a darle tareas claras a la IA y a comprobar sus respuestas
- 1Cómo funciona la IA, sin magia
- 2Cómo pedir textos
- 3Verificación de datos y «alucinaciones»
- 4Imágenes
- Más etapas: 4
Herramienta en línea para reconocer texto en fotos, escaneos y PDF. Un motor de redes neuronales lee el documento directamente en el navegador en español, inglés y más de 100 idiomas, endereza las fotos giradas y alinea los renglones de las fotos tomadas con el celular; obtienes texto editable, Word, Excel o un PDF con búsqueda y capa de texto invisible.
Suelta imágenes o PDF, fotografía el documento con la cámara del celular o pega una captura de pantalla con Ctrl+V.
La opción predeterminada cubre el idioma del sitio más el inglés; para otros documentos, elige hasta tres idiomas en el desplegable agrupado.
Texto plano para copiar y pegar, Conservar formato para documentos, Extraer tablas para hojas de cálculo, o Recibo para totales, fechas y vendedores.
Inspecciona las cajas delimitadoras, corrige las palabras de baja confianza en línea y busca palabras concretas.
Descarga como TXT, DOCX, XLSX o PDF buscable — o agrupa todo el lote en un ZIP.
Curso de inteligencia artificial para principiantes
Aprende a darle tareas claras a la IA y a comprobar sus respuestas
Audio a texto
Convierta una conversación grabada en un documento legible: quién dijo qué y cuándo
Populares ahora mismo
Suelta imágenes o PDF aquí
O presiona Ctrl+V para pegar una captura de pantalla
Activa estas opciones para escaneos de baja calidad, fotos de móvil o recibos con ruido.
Todos los archivos ya están reconocidos con esta configuración. Cambia el idioma o el estilo de salida y el botón los leerá de nuevo.
Haz clic en una caja para saltar a la palabra · haz clic en la palabra para resaltar la caja · Edita cualquier palabra en línea — tus correcciones se guardan en la exportación.
La foto de una página y el texto que el modo preciso devolvió para ella, palabra por palabra y sin editar, errores incluidos.
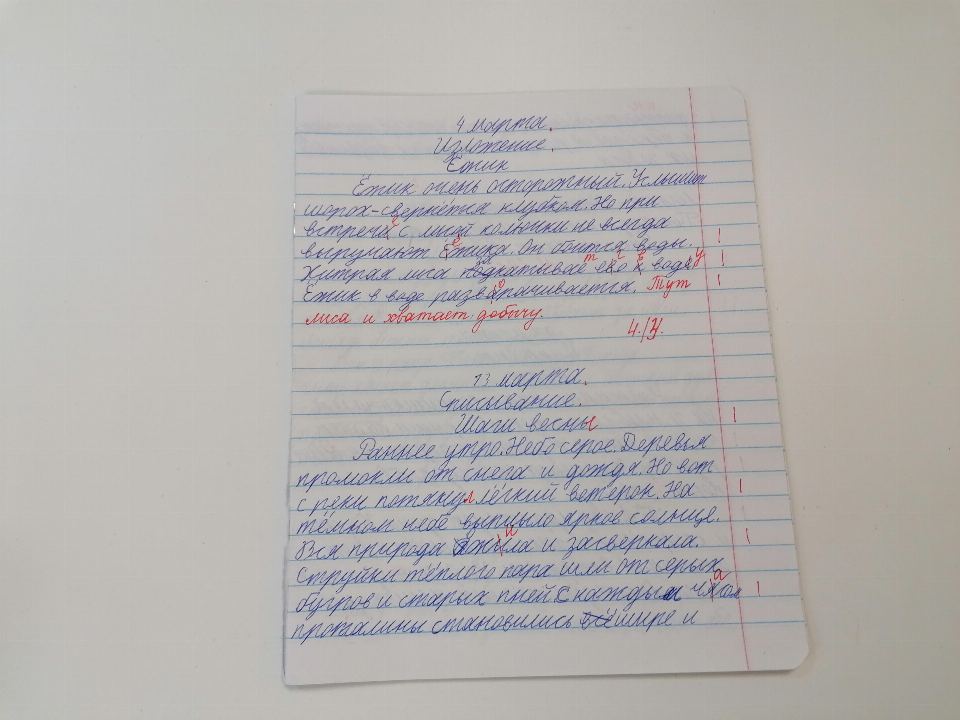
4 марта.
Изложение.
Ёжик
Ёжик очень осторожный. Услышит
шорох - свернётся клубком. Но при
встрече с лисой колючки не всегда
выручают ёжика. Он боится воды.
Хитрая лиса подкатывае его к воде. У
Ёжик в воде разворачивается. Тут
лиса и хватает добычу.
4/3.
13 марта.
Списывание.
Шаги весны
Раннее утро. Небо серое. Деревья
промокли от снега и дождя. Но вот
с реки потянул лёгкий ветерок. На
тёмном небе выплыло яркое солнце.
Вся природа ожила и засверкала.
Струйки тёплого пара шли от серых а
бугров и старых пней с каждым часом
проталины становились всё шире и
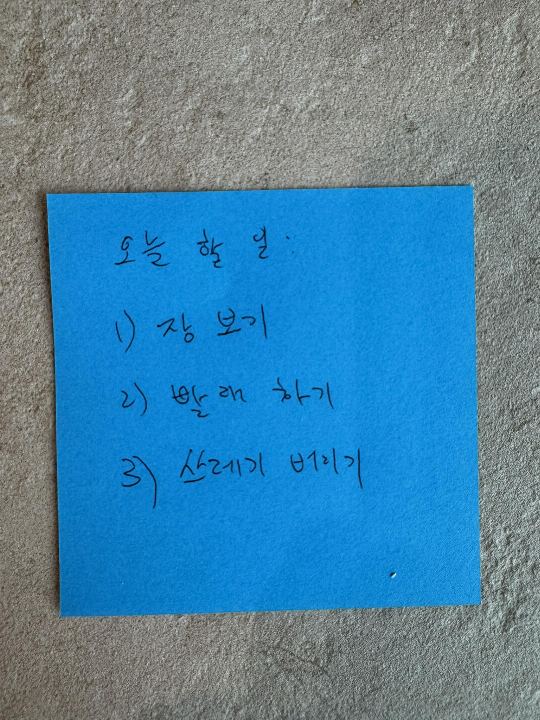
오늘 할 일 :
1) 장 보기
2) 빨래 하기
3) 쓰레기 버리기
Curso de inteligencia artificial para principiantes
Aprende a darle tareas claras a la IA y a comprobar sus respuestas
Audio a texto
Convierta una conversación grabada en un documento legible: quién dijo qué y cuándo
Entrada: JPG, PNG, WebP, TIFF, BMP, HEIC, PDF (varias páginas). Salida: TXT, DOCX, XLSX, PDF buscable, Markdown, JSON con cajas delimitadoras.
El texto impreso limpio se reconoce casi sin errores; las fotos del celular y los escaneos desvaídos son más difíciles. El motor endereza las fotos giradas y lee cada renglón en su propio marco inclinado, y las palabras de baja confianza quedan resaltadas para que puedas corregirlas antes de exportar.
El motor neuronal lee español, inglés y los demás idiomas de escritura latina y cirílica, chino, japonés, coreano, árabe, griego, hindi y tailandés; cerca de cien idiomas más —hebreo, georgiano, vietnamita, bengalí y otros— los reconoce Tesseract. Los idiomas se agrupan por escritura en la lista; los modelos se cargan en el primer uso y quedan en la caché del navegador.
Sí. Los PDF de varias páginas se renderizan página a página con pdf.js y luego pasan por OCR. También puedes exportar el resultado de vuelta como un PDF buscable con capa de texto invisible, así Ctrl+F funciona y los lectores de pantalla pueden leerlo.
El modo normal está ajustado para texto impreso: la letra clara con letras separadas suele leerse, la cursiva no. Para manuscritos está “Reconocer con más precisión”: la página se envía a un servidor de reconocimiento y la lee un modelo hecho para escritura a mano. En páginas de cuadernos escolares leyó bien casi 9 de cada 10 palabras; el modo normal, menos de 1 de cada 10.
Tras el OCR agrupamos las palabras reconocidas por su posición vertical en filas y dividimos las filas en columnas según los huecos horizontales. Cuando al menos tres filas comparten el mismo número de columnas las tratamos como una tabla y la exportamos como filas y columnas en Excel; en caso contrario, el archivo Excel tendrá una sola columna de texto.
La cola admite hasta 50 archivos. Cuántos archivos se reconocen al día y cuántas páginas de PDF lee una pasada se muestra en el recuadro arriba del botón «Extraer texto». El tope de tamaño por archivo se adapta a tu dispositivo (desde unos 80 MB en celulares hasta 1 GB en computadoras); los PDF se procesan página a página, y un documento grande ofrece un selector de rango de páginas.
¡Podemos hacerlo! Solo envíanos un mensaje rápido con tu idea. Si quieres comentarla en detalle, déjanos tu email y te responderemos. Puedes mantener el anonimato.
Al subir contenido, usted confirma que está facultado para comunicar su contenido a terceros y se compromete a no incluir datos personales de terceros. Más detalles en las Condiciones de uso. Proveedores de IA Tembrica es un producto independiente. No estamos afiliados, avalados ni patrocinados por los creadores de los modelos y servicios aquí indicados; sus nombres se usan solo para indicar con exactitud qué motor ejecuta cada herramienta.
Reporta un problema o sugiere una mejora. ¡Lo leemos todo!
Tu mensaje se ha enviado. Lo revisaremos en breve.
Оплата через СБП · ₽
Откройте приложение банка, выберите «Оплатить по QR» и наведите камеру на код.
Открыть приложение банкаЖдём подтверждения от банка…
Открыть ссылку на оплату