Curso de inteligência artificial para iniciantes
Aprenda a dar tarefas claras à inteligência artificial e a conferir as respostas dela
- 1Como a IA funciona, sem mistério
- 2Como pedir textos
- 3Checagem de fatos e «alucinações»
- 4Imagens
- Mais etapas: 4
Ferramenta online para reconhecer texto em fotos, digitalizações e PDFs. Um motor de rede neural lê o documento direto no navegador em português, inglês e mais de 100 outros idiomas, endireita fotos de lado e alinha as linhas de fotos de celular; o resultado é texto editável, Word, Excel ou PDF pesquisável com camada de texto invisível.
Arraste imagens ou PDFs, fotografe o documento com a câmera do celular ou cole uma captura de tela com Ctrl+V.
O padrão cobre o idioma do site mais o inglês; para outros documentos, selecione até três idiomas no menu agrupado.
Texto simples para copiar e colar, Preservar layout para documentos, Extrair tabelas para planilhas ou Recibo para totais, datas e vendedores.
Inspecione as caixas, corrija palavras de baixa confiança inline, busque termos específicos.
Baixe como TXT, DOCX, XLSX ou PDF pesquisável — ou empacote todo o lote em um ZIP.
Curso de inteligência artificial para iniciantes
Aprenda a dar tarefas claras à inteligência artificial e a conferir as respostas dela
Áudio em texto
Transforme uma conversa gravada em um documento legível: quem disse o quê e quando
Em alta agora
Solte imagens ou PDFs aqui
Ou pressione Ctrl+V para colar uma captura de tela
Ative para digitalizações de baixa qualidade, fotos de celular ou recibos com ruído.
Todos os arquivos já foram reconhecidos com estas configurações. Mude o idioma ou o estilo de saída e o botão vai lê-los de novo.
Clique numa caixa para ir à palavra · clique na palavra para destacar a caixa · Edite qualquer palavra inline — suas correções vão para a exportação.
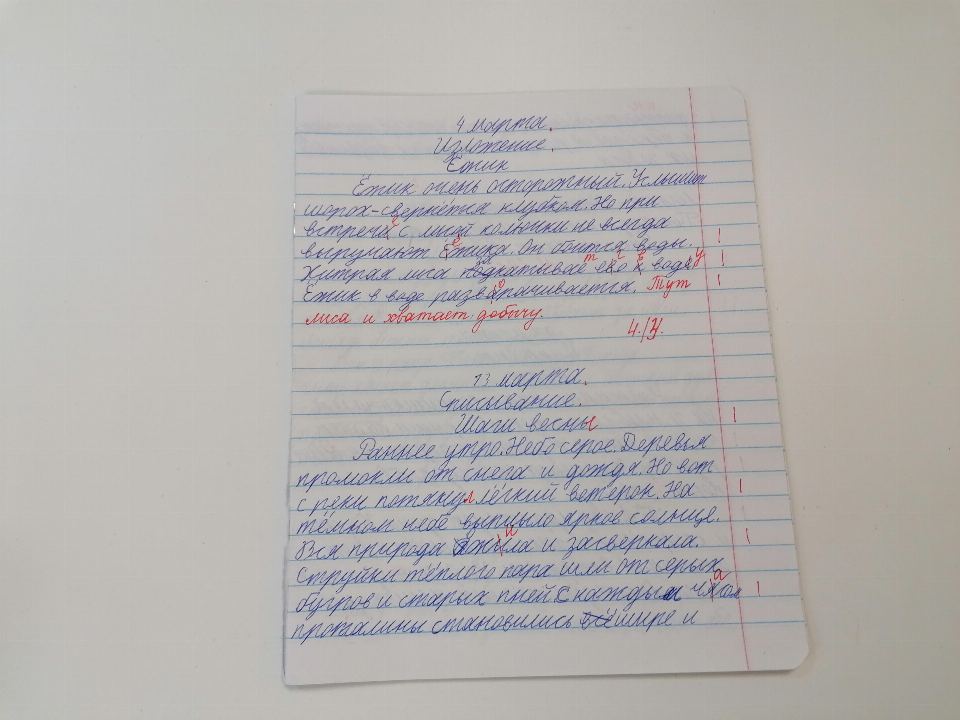
A foto da página e o texto que o modo preciso devolveu para ela, palavra por palavra e sem edição — erros incluídos.
4 марта.
Изложение.
Ёжик
Ёжик очень осторожный. Услышит
шорох - свернётся клубком. Но при
встрече с лисой колючки не всегда
выручают ёжика. Он боится воды.
Хитрая лиса подкатывае его к воде. У
Ёжик в воде разворачивается. Тут
лиса и хватает добычу.
4/3.
13 марта.
Списывание.
Шаги весны
Раннее утро. Небо серое. Деревья
промокли от снега и дождя. Но вот
с реки потянул лёгкий ветерок. На
тёмном небе выплыло яркое солнце.
Вся природа ожила и засверкала.
Струйки тёплого пара шли от серых а
бугров и старых пней с каждым часом
проталины становились всё шире и
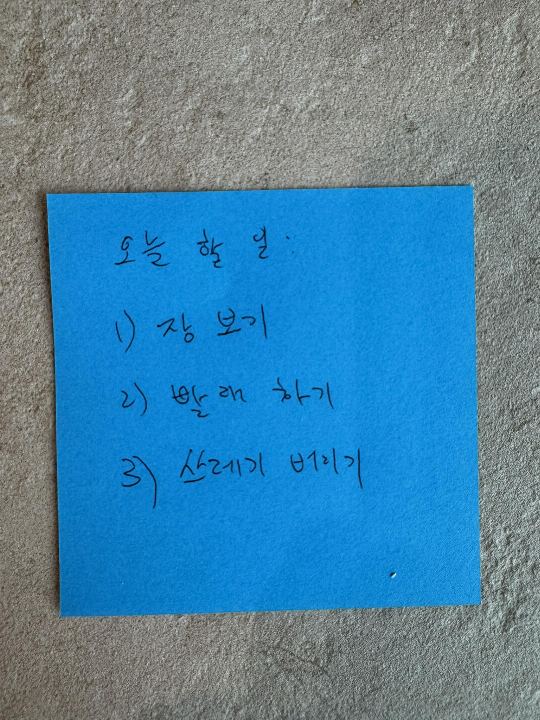
오늘 할 일 :
1) 장 보기
2) 빨래 하기
3) 쓰레기 버리기
Curso de inteligência artificial para iniciantes
Aprenda a dar tarefas claras à inteligência artificial e a conferir as respostas dela
Áudio em texto
Transforme uma conversa gravada em um documento legível: quem disse o quê e quando
Entrada: JPG, PNG, WebP, TIFF, BMP, HEIC, PDF (multi-página). Saída: TXT, DOCX, XLSX, PDF pesquisável, Markdown, JSON com caixas delimitadoras.
Texto impresso limpo é reconhecido quase sem erros; fotos de celular e digitalizações desbotadas são mais difíceis. O motor endireita fotos de lado e lê cada linha no seu próprio quadro inclinado, e as palavras de baixa confiança ficam destacadas para você corrigir antes de exportar.
O motor neural lê português, inglês e os demais idiomas de escrita latina e cirílica, chinês, japonês, coreano, árabe, grego, hindi e tailandês; cerca de cem outros — hebraico, georgiano, vietnamita, bengali e mais — são reconhecidos pelo Tesseract. Os idiomas são agrupados por escrita na lista; os modelos são carregados no primeiro uso e ficam no cache do navegador.
Sim. PDFs multi-página são renderizados página a página via pdf.js e então passam pelo OCR. Você também pode exportar o resultado de volta como um PDF pesquisável com camada de texto invisível, para que Ctrl+F funcione e leitores de tela possam lê-lo.
O modo comum é ajustado para texto impresso: letra clara com letras separadas costuma ser lida, a cursiva não. Para manuscritos existe “Reconhecer com mais precisão”: a página é enviada a um servidor de reconhecimento e lida por um modelo feito para caligrafia. Em páginas de cadernos escolares ele leu corretamente quase 9 de cada 10 palavras; o modo comum, menos de 1 em 10.
Após o OCR agrupamos as palavras reconhecidas pela posição vertical em linhas e dividimos as linhas em colunas com base nos espaços horizontais. Quando pelo menos três linhas compartilham o mesmo número de colunas, tratamos como tabela e exportamos como linhas e colunas no Excel; caso contrário, o arquivo Excel tem apenas uma coluna de texto.
A fila aceita até 50 arquivos. Quantos arquivos são reconhecidos por dia e quantas páginas de PDF uma passada lê aparecem no quadro acima do botão «Extrair texto». O limite de tamanho por arquivo se adapta ao dispositivo (de cerca de 80 MB em celulares até 1 GB em desktops); PDFs são processados página a página, e um documento grande ganha um seletor de intervalo de páginas.
Podemos! Envie uma mensagem rápida com sua ideia. Se quiser discutir em detalhes, deixe seu email e entraremos em contato. Pode ser anônimo.
Ao enviar conteúdo, você confirma que está autorizado a divulgá-lo a terceiros e se compromete a não incluir dados pessoais de terceiros. Veja os Termos de Uso. Provedores de IA Tembrica é um produto independente. Não temos afiliação, endosso ou patrocínio dos criadores dos modelos e serviços listados aqui; os nomes constam apenas para informar com precisão qual motor executa cada ferramenta.
Reporte um problema ou sugira uma melhoria. Lemos tudo!
Sua mensagem foi enviada. Analisaremos em breve.
Оплата через СБП · ₽
Откройте приложение банка, выберите «Оплатить по QR» и наведите камеру на код.
Открыть приложение банкаЖдём подтверждения от банка…
Открыть ссылку на оплату